|
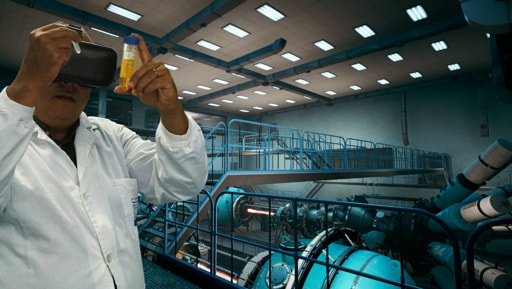
Medicina - Inteligencia Artificial - Legaltech  Investigadores del Instituto Nacional del Cáncer revisan datos experimentales en pantalla. · Fotografía: Rhoda Baer, National Cancer Institute (NIH), Public Domain Una reflexión sobre el artículo de nuestro compañero, el ingeniero especialista en IA, Josep Salvador en LISA News, ampliada desde nuestra práctica en el tratamiento de datos y el software para la investigación sanitaria. Queridos lectores, hay una parte del trabajo con inteligencia artificial en sanidad que nunca sale en las presentaciones. No es la arquitectura del modelo, ni la curva de aprendizaje, ni el porcentaje de acierto que se enseña en la última diapositiva. Es lo que ocurre antes: alguien decide qué variable se registra, con qué unidad, en qué campo del formulario y bajo qué criterio; alguien concilia dos historias clínicas que se refieren al mismo paciente; alguien descubre que un valor de laboratorio de 2019 se codificaba de otra manera. Ese trabajo, lento y sin brillo, es el que determina si el sistema que se construya encima tendrá algún valor clínico.
Nuestro compañero en Quantum Babylon – Acudesic, el ingeniero informático experto en IA Josep Salvador, ha publicado en LISA News un artículo que se ocupa precisamente de eso: «Cuando los datos importan más que el algoritmo». Su tesis es directa y la compartimos entera: la inteligencia artificial puede analizar volúmenes enormes de información y acelerar la investigación médica, pero su valor real no depende de la potencia del modelo, sino de la calidad de aquello con lo que aprende. Desde el trabajo que hacemos a diario en Quantum Babylon queremos acompañar ese argumento, ampliarlo con evidencia publicada y mostrar hasta qué punto la comunidad científica lleva años llegando a la misma conclusión por caminos distintos. Conviene decir desde dónde escribimos. En Quantum Babylon desarrollamos sistemas de soporte a la decisión clínica, análisis de datos sanitarios y software para investigación biomédica, y colaboramos con universidades, hospitales y centros de investigación. Esa posición nos ha dejado una lección repetida hasta la saciedad: la mayor parte del criterio de un proyecto de IA clínica se juega antes de entrenar nada. Josep parte de la misma convicción, y merece la pena recorrerla con calma. Un algoritmo no rescata a un dato malo El artículo desmonta una idea cómoda que circula con más frecuencia de la que sería deseable: la de que un sistema suficientemente avanzado compensará los defectos de la información de origen. Como escribe Josep, un algoritmo puede detectar relaciones, clasificar y predecir, pero «no convierte automáticamente datos malos en conocimiento útil». Los errores de registro, las duplicidades, los valores ausentes y los sesgos siguen ahí después del entrenamiento, solo que ahora vienen envueltos en una cifra de precisión que invita a confiar. La informática lleva décadas resumiendo esto con una fórmula proverbial, garbage in, garbage out, y en medicina la broma pierde la gracia. Josep lo formula con más precisión: la IA amplifica la capacidad de análisis, pero también amplifica los problemas que ya existían en los datos. Un modelo entrenado con información poco diversa rinde peor en determinados grupos de pacientes; un análisis construido sobre registros incompletos produce conclusiones débiles; una predicción levantada sobre códigos mal asignados orienta mal una línea de investigación entera. La literatura sobre calidad del dato clínico avala esa cautela desde mucho antes de que la IA generativa ocupara los titulares. Una revisión metodológica muy citada ordenó la calidad de los datos de la historia clínica electrónica en cinco dimensiones —completitud, corrección, concordancia, plausibilidad y actualidad— y advirtió de que apenas existía consistencia en la forma de medirlas (Weiskopf y Weng, 2013). Diez años después, una revisión sistemática de la literatura publicada entre 2013 y 2023 constataba que seguía sin haber un enfoque estándar para evaluar la calidad de los datos clínicos, y que la completitud continuaba acaparando la atención mientras las demás dimensiones quedaban en segundo plano (Lewis et al., 2023). Una década de trabajo académico no ha bastado para consolidar una práctica común. Ese es el hueco que el artículo de Josep señala. El trabajo del dato, el que nadie quiere hacer Hay una razón cultural detrás de este desequilibrio, y está documentada. Un estudio presentado en la conferencia CHI de 2021 entrevistó a profesionales que desarrollan sistemas de IA de alto riesgo en India, África Oriental, África Occidental y Estados Unidos, y encontró lo que sus autores llamaron data cascades: problemas de origen en los datos que se mantienen ocultos durante meses y estallan después, aguas abajo, en forma de modelos inservibles o de daños a las personas afectadas. La prevalencia era del 92 % entre los profesionales consultados, y el título del trabajo resume el diagnóstico mejor que cualquier paráfrasis: todo el mundo quiere hacer el trabajo del modelo, nadie quiere hacer el trabajo del dato (Sambasivan et al., 2021). Ese desdén tiene consecuencias que se pueden medir. En imagen médica, por ejemplo, la preparación del conjunto de datos —selección de casos, control de calidad de las adquisiciones, anotación por parte de expertos, separación honesta entre entrenamiento y validación— consume la mayor parte del esfuerzo de un proyecto y condiciona todo lo demás; una revisión de referencia en Radiology dedicó un artículo completo a ordenar ese proceso, precisamente porque se suele despachar en un párrafo del apartado de métodos (Willemink et al., 2020). La respuesta que ha ido cuajando en la comunidad es documental antes que técnica. La propuesta de las datasheets for datasets pide que todo conjunto de datos venga acompañado de una ficha que explique con qué motivación se creó, cómo se recogió, qué población representa, qué preprocesado sufrió y para qué usos no es adecuado (Gebru et al., 2021). Es el equivalente a la hoja de características de un componente electrónico, y en sanidad debería ser un requisito, no una buena práctica opcional. Josep lo dice con otras palabras cuando insiste en el contexto: saber de dónde viene un dato, cuándo se obtuvo y en qué condiciones se registró es casi tan importante como el dato mismo. En nuestro trabajo esa exigencia se traduce en algo muy concreto. Antes de proponer un modelo pedimos ver el formulario de captura, el diccionario de variables y el historial de cambios del sistema de origen. Si un centro cambió de proveedor de laboratorio a mitad de la serie temporal, eso no es un detalle administrativo: es una discontinuidad que el modelo aprenderá como si fuera una señal clínica. Cuando la variable mide otra cosa distinta de la que creemos El apartado que Josep dedica al sesgo es, para nosotros, el más importante del artículo, porque desmiente una intuición muy extendida. El problema, escribe, «no siempre está en el algoritmo; muchas veces está en la muestra, en la forma de registrar la información o en las decisiones tomadas durante la preparación de los datos». El caso que mejor ilustra esa afirmación no es una historia de mala fe ni un fallo de programación espectacular. Un algoritmo utilizado en Estados Unidos para seleccionar pacientes candidatos a programas de atención reforzada predecía el gasto sanitario como aproximación a la necesidad clínica, una decisión de diseño en apariencia razonable. El problema es que en la población negra se gasta históricamente menos a igual nivel de enfermedad, de modo que el sistema la infravaloraba de forma sistemática. Corregir ese sesgo habría elevado el porcentaje de pacientes negros señalados para recibir ayuda adicional del 17,7 % al 46,5 % (Obermeyer et al., 2019). La variable elegida medía una cosa —dinero gastado— y se estaba leyendo como si midiera otra —gravedad clínica—. Ninguna sofisticación algorítmica corrige un error de ese tipo. Los mecanismos por los que las historias clínicas electrónicas introducen sesgos están, además, bien catalogados: información ausente y pacientes que el sistema no llega a identificar, tamaños de muestra que infrarrepresentan a determinados grupos, y errores de clasificación y de medición (Gianfrancesco et al., 2018). A esos tres se suma un problema de representatividad geográfica que rara vez se comenta. Una revisión de los estudios estadounidenses de aprendizaje profundo halló que el 71 % se había entrenado con cohortes procedentes de solo tres estados —California, Massachusetts y Nueva York—, mientras que treinta y cuatro estados no aportaban ni un solo paciente (Kaushal et al., 2020). Un modelo así hereda el mapa de sus datos, no el del mundo real. Y las consecuencias llegan hasta el diagnóstico. Al aplicar visión artificial a radiografías de tórax, varios clasificadores de referencia infradiagnosticaban de manera sistemática a las poblaciones desatendidas, con tasas todavía peores en subgrupos concretos como las mujeres hispanas (Seyyed-Kalantari et al., 2021). El modelo no era peor en general; era peor con quienes ya partían en desventaja, que es la forma más silenciosa de fallar. Lo que un modelo aprende sin que se lo pidan Hay un fenómeno que conviene añadir al argumento de Josep, porque explica muchos fracasos que después se atribuyen a la tecnología. Los modelos aprenden lo que hay en los datos, y en los datos hay mucho más de lo que pretendíamos poner. El ejemplo clásico está en neumología. Un estudio comparó redes neuronales entrenadas para detectar neumonía en radiografías de tórax de distintos hospitales y descubrió dos cosas incómodas a la vez: el rendimiento caía de forma significativa al aplicarlas fuera del centro de origen, y las redes eran capaces de identificar el hospital de procedencia de una radiografía con una precisión casi perfecta (Zech et al., 2018). Habían aprendido el marcador del aparato, la posición del paciente, la prevalencia local. Nada de eso es medicina, y todo eso predice. La pandemia dejó una demostración a gran escala. Una revisión sistemática de los modelos de aprendizaje automático propuestos para diagnosticar o pronosticar la COVID-19 a partir de radiografías y tomografías revisó más de dos mil publicaciones y evaluó en detalle sesenta y dos estudios: ninguno resultó de utilidad clínica potencial, por defectos metodológicos, sesgos en los conjuntos de datos o falta de reproducibilidad y validación externa (Roberts et al., 2021). Miles de horas de cómputo, decenas de equipos competentes y ningún modelo aprovechable, casi siempre por problemas del dato. También hay ejemplos ya desplegados en hospitales. La validación externa de un modelo comercial de predicción de sepsis, integrado en la historia clínica electrónica de cientos de centros estadounidenses, encontró un área bajo la curva de 0,63, muy por debajo del 0,76 a 0,83 que declaraba el fabricante; el sistema generaba alertas en el 18 % de todos los pacientes hospitalizados y solo detectaba a tiempo al 7 % de los casos de sepsis que la práctica clínica no había identificado ya (Wong et al., 2021). Un modelo puede estar en producción, integrado y funcionando, y aun así no sostener lo que promete. A esto se añade la degradación con el tiempo. El dataset shift aparece cuando los datos sobre los que trabaja el sistema dejan de parecerse a aquellos con los que se desarrolló. Durante 2020, un modelo hospitalario tuvo que desactivarse porque las características demográficas de los pacientes cambiaron y empezó a generar alertas espurias (Finlayson et al., 2021). Un algoritmo clínico no es un producto que se termina y se olvida, sino un sistema que exige vigilancia continua sobre los datos que recibe. Privacidad: anonimizar no es quitar el nombre Josep dedica un apartado a la privacidad y a la confianza del paciente, y señala las piezas correctas: anonimización, minimización, control de accesos y trazabilidad. Merece la pena subrayar por qué la primera de esas piezas es más difícil de lo que parece. Un trabajo publicado en Nature Communications estimó que el 99,98 % de los estadounidenses podrían ser reidentificados correctamente en cualquier conjunto de datos usando quince atributos demográficos, y mostró que las técnicas habituales de anonimización por muestreo no bastan para cumplir los criterios de las normativas de protección de datos (Rocher et al., 2019). Retirar el nombre y el número de historia clínica no convierte un conjunto de datos en anónimo: la combinación de código postal, fecha de nacimiento, sexo y unas pocas variables clínicas vuelve a señalar a una persona concreta. De ahí que las arquitecturas que evitan mover el dato hayan ganado terreno. El aprendizaje federado permite entrenar un modelo con la información de varias instituciones sin que los datos salgan de cada una de ellas, y se ha propuesto como uno de los caminos practicables para la investigación multicéntrica en salud (Rieke et al., 2020). No es una solución mágica —también arrastra problemas de heterogeneidad y de gobierno—, pero desplaza el riesgo hacia donde se puede controlar mejor. El marco normativo europeo va en la misma dirección y ha dejado de ser una recomendación.El Reglamento sobre el Espacio Europeo de Datos Sanitarios ordena tanto el uso primario de la información —la atención al paciente— como el secundario —investigación, innovación y políticas públicas— y fija requisitos de calidad, trazabilidad y gobierno del dato (Reglamento (UE) 2025/327, 2025). Junto a él, el Reglamento de Inteligencia Artificial clasifica buena parte de los sistemas sanitarios como de alto riesgo y les exige, entre otras cosas, prácticas de gobernanza de datos de entrenamiento, validación y prueba que sean pertinentes, representativos y, en la medida de lo posible, libres de errores (Reglamento (UE) 2024/1689, 2024). Lo que hasta hace poco era criterio profesional ahora es una obligación con inspección detrás. La confianza del paciente, que Josep pone en el centro, se sostiene sobre eso. No sobre una declaración de intenciones en la web del proyecto, sino sobre poder explicar con precisión qué información se usa, con qué garantías y con qué límites. La supervisión humana, con letra pequeña El último apartado del artículo defiende que la IA debe funcionar como herramienta de apoyo y no como autoridad incuestionable, y que los profesionales deben interpretar los resultados, revisar las limitaciones del modelo y comprobar si las conclusiones tienen sentido clínico. Estamos de acuerdo, y queremos añadir una advertencia: la supervisión humana funciona peor de lo que se supone cuando se diseña como un trámite. El fenómeno se llama sesgo de automatización y consiste en la tendencia a aceptar la recomendación del sistema y a dejar de buscar información contradictoria. Una revisión sistemática sobre sistemas de apoyo a la decisión clínica encontró que la frecuencia de este sesgo depende de factores como la confianza depositada en el sistema, la carga de trabajo y la experiencia del profesional, y que las recomendaciones incorrectas empeoran decisiones que el clínico habría acertado sin ayuda (Goddard et al., 2012). Poner a una persona al final de la cadena no basta; hay que darle el contexto, el tiempo y la información sobre las limitaciones del modelo que necesita para discrepar de él. El propio Reglamento de Inteligencia Artificial recoge esa exigencia en su artículo dedicado a la vigilancia humana, que obliga a que los sistemas de alto riesgo se diseñen de manera que puedan ser supervisados de forma efectiva, incluida la capacidad de interpretar correctamente los resultados y de no confiar automáticamente en ellos (Reglamento (UE) 2024/1689, 2024). Y para poder supervisar hace falta poder leer lo que se ha hecho. Aquí la investigación sanitaria arrastra un problema conocido: la reproducibilidad de los modelos de aprendizaje automático en salud es baja, en buena medida porque no se publican ni los datos, ni el código, ni los detalles del preprocesado (Beam et al., 2020). La guía TRIPOD+AI, publicada en 2024, fija cómo deben describirse los estudios de modelos de predicción clínica, incluidos los de aprendizaje automático, con atención explícita a la procedencia de los datos, la equidad y la transparencia del proceso (Collins et al., 2024). Es la infraestructura documental sin la cual la supervisión humana se queda en un gesto. Traslación a un proyecto real Todo lo anterior puede sonar a exigencia de manual. En la práctica se concreta en decisiones pequeñas y tozudas que ocupan las primeras semanas de cualquier proyecto serio. Significa exigir un diccionario de variables antes que un conjunto de datos. Significa medir la completitud y la coherencia por centro y por periodo, y no en agregado, porque el agregado esconde justo lo que interesa. Significa comprobar la representatividad de la muestra frente a la población a la que se pretende aplicar el modelo, y decir en voz alta a quién no cubre. Significa registrar cada transformación del dato de modo que se pueda reconstruir el camino desde el valor original hasta la cifra que ve el clínico. Y significa acordar desde el principio quién vigila el modelo cuando ya está funcionando, con qué indicadores y con qué umbral para apagarlo. En Quantum Babylon abordamos esa exigencia como parte inseparable del desarrollo. Cuando diseñamos un sistema de soporte a la decisión clínica, un análisis para investigación o un entorno seguro para compartir información, la validación y la gobernanza del dato forman el armazón sobre el que se levanta lo demás. Preferimos gastar tiempo en depurar el origen antes que perseguir errores en la salida, porque sale más barato y, sobre todo, más seguro. Una lectura más que recomendada El artículo de Josep Salvador tiene la virtud de decir con serenidad algo que la evidencia confirma una y otra vez: que el futuro de la inteligencia artificial en salud no se decidirá solo en los laboratorios tecnológicos, sino en la forma en que hospitales, investigadores, administraciones y empresas gestionen sus datos. Nosotros hemos querido acompañar su reflexión con cifras y estudios que muestran hasta dónde llega ese principio, desde un algoritmo que confundía gasto con enfermedad hasta miles de modelos de pandemia que no sirvieron para nada. Su artículo cierra con una pregunta que suscribimos y que debería preceder a cualquier despliegue: antes de confiar en una predicción, una clasificación o una recomendación automatizada, ¿son fiables los datos que la sostienen? Os animamos a leer el texto completo, publicado en LISA News, disponible en este enlace: https://www.lisanews.org/ciberseguridad/cuando-los-datos-importan-mas-que-el-algoritmo/ Referencias Beam, A. L., Manrai, A. K., y Ghassemi, M. (2020). Challenges to the reproducibility of machine learning models in health care. JAMA, 323(4), 305–306. https://doi.org/10.1001/jama.2019.20866 Collins, G. S., Moons, K. G. M., Dhiman, P., Riley, R. D., Beam, A. L., Van Calster, B., Ghassemi, M., Liu, X., Reitsma, J. B., van Smeden, M., … Logullo, P. (2024). TRIPOD+AI statement: Updated guidance for reporting clinical prediction models that use regression or machine learning methods. The BMJ, 385, e078378. https://doi.org/10.1136/bmj-2023-078378 Finlayson, S. G., Subbaswamy, A., Singh, K., Bowers, J., Kupke, A., Zittrain, J., Kohane, I. S., y Saria, S. (2021). The clinician and dataset shift in artificial intelligence. New England Journal of Medicine, 385(3), 283–286. https://doi.org/10.1056/NEJMc2104626 Gebru, T., Morgenstern, J., Vecchione, B., Wortman Vaughan, J., Wallach, H., Daumé III, H., y Crawford, K. (2021). Datasheets for datasets. Communications of the ACM, 64(12), 86–92. https://doi.org/10.1145/3458723 Gianfrancesco, M. A., Tamang, S., Yazdany, J., y Schmajuk, G. (2018). Potential biases in machine learning algorithms using electronic health record data. JAMA Internal Medicine, 178(11), 1544–1547. https://doi.org/10.1001/jamainternmed.2018.3763 Goddard, K., Roudsari, A., y Wyatt, J. C. (2012). Automation bias: A systematic review of frequency, effect mediators, and mitigators. Journal of the American Medical Informatics Association, 19(1), 121–127. https://doi.org/10.1136/amiajnl-2011-000089 Kaushal, A., Altman, R., y Langlotz, C. (2020). Geographic distribution of US cohorts used to train deep learning algorithms. JAMA, 324(12), 1212–1213. https://doi.org/10.1001/jama.2020.12067 Lewis, A. E., Weiskopf, N., Abrams, Z. B., Foraker, R., Lai, A. M., Payne, P. R. O., y Gupta, A. (2023). Electronic health record data quality assessment and tools: A systematic review. Journal of the American Medical Informatics Association, 30(10), 1730–1740. https://doi.org/10.1093/jamia/ocad120 Obermeyer, Z., Powers, B., Vogeli, C., y Mullainathan, S. (2019). Dissecting racial bias in an algorithm used to manage the health of populations. Science, 366(6464), 447–453. https://doi.org/10.1126/science.aax2342 Reglamento (UE) 2024/1689 del Parlamento Europeo y del Consejo, de 13 de junio de 2024, por el que se establecen normas armonizadas en materia de inteligencia artificial. Diario Oficial de la Unión Europea, L, 2024/1689, 12 de julio de 2024. http://data.europa.eu/eli/reg/2024/1689/oj Reglamento (UE) 2025/327 del Parlamento Europeo y del Consejo, de 11 de febrero de 2025, sobre el Espacio Europeo de Datos Sanitarios y por el que se modifican la Directiva 2011/24/UE y el Reglamento (UE) 2024/2847. Diario Oficial de la Unión Europea, L, 2025/327, 5 de marzo de 2025. http://data.europa.eu/eli/reg/2025/327/oj Rieke, N., Hancox, J., Li, W., Milletarì, F., Roth, H. R., Albarqouni, S., Bakas, S., Galtier, M. N., Landman, B. A., Maier-Hein, K., Ourselin, S., Sheller, M., Summers, R. M., Trask, A., Xu, D., Baust, M., y Cardoso, M. J. (2020). The future of digital health with federated learning. npj Digital Medicine, 3, 119. https://doi.org/10.1038/s41746-020-00323-1 Roberts, M., Driggs, D., Thorpe, M., Gilbey, J., Yeung, M., Ursprung, S., Aviles-Rivero, A. I., Etmann, C., McCague, C., Beer, L., Weir-McCall, J. R., Teng, Z., Gkrania-Klotsas, E., … Schönlieb, C.-B. (2021). Common pitfalls and recommendations for using machine learning to detect and prognosticate for COVID-19 using chest radiographs and CT scans. Nature Machine Intelligence, 3(3), 199–217. https://doi.org/10.1038/s42256-021-00307-0 Rocher, L., Hendrickx, J. M., y de Montjoye, Y.-A. (2019). Estimating the success of re-identifications in incomplete datasets using generative models. Nature Communications, 10, 3069. https://doi.org/10.1038/s41467-019-10933-3 Salvador López, J. (2026, 14 de agosto). Cuando los datos importan más que el algoritmo. LISA News. https://www.lisanews.org/ciberseguridad/cuando-los-datos-importan-mas-que-el-algoritmo/ Sambasivan, N., Kapania, S., Highfill, H., Akrong, D., Paritosh, P., y Aroyo, L. M. (2021). «Everyone wants to do the model work, not the data work»: Data cascades in high-stakes AI. En Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems (art. 39, pp. 1–15). Association for Computing Machinery. https://doi.org/10.1145/3411764.3445518 Seyyed-Kalantari, L., Zhang, H., McDermott, M. B. A., Chen, I. Y., y Ghassemi, M. (2021). Underdiagnosis bias of artificial intelligence algorithms applied to chest radiographs in under-served patient populations. Nature Medicine, 27(12), 2176–2182. https://doi.org/10.1038/s41591-021-01595-0 Weiskopf, N. G., y Weng, C. (2013). Methods and dimensions of electronic health record data quality assessment: Enabling reuse for clinical research. Journal of the American Medical Informatics Association, 20(1), 144–151. https://doi.org/10.1136/amiajnl-2011-000681 Willemink, M. J., Koszek, W. A., Hardell, C., Wu, J., Fleischmann, D., Harvey, H., Folio, L. R., Summers, R. M., Rubin, D. L., y Lungren, M. P. (2020). Preparing medical imaging data for machine learning. Radiology, 295(1), 4–15. https://doi.org/10.1148/radiol.2020192224 Wong, A., Otles, E., Donnelly, J. P., Krumm, A., McCullough, J., DeTroyer-Cooley, O., Pestrue, J., Phillips, M., Konye, J., Penoza, C., Ghous, M., y Singh, K. (2021). External validation of a widely implemented proprietary sepsis prediction model in hospitalized patients. JAMA Internal Medicine, 181(8), 1065–1070. https://doi.org/10.1001/jamainternmed.2021.2626 Zech, J. R., Badgeley, M. A., Liu, M., Costa, A. B., Titano, J. J., y Oermann, E. K. (2018). Variable generalization performance of a deep learning model to detect pneumonia in chest radiographs: A cross-sectional study. PLOS Medicine, 15(11), e1002683. https://doi.org/10.1371/journal.pmed.1002683 Créditos de las imágenes Portada: «Researchers Review Cancer Data», fotografía de Rhoda Baer para el National Cancer Institute (National Institutes of Health, EE. UU.), dominio público, vía Wikimedia Commons (https://commons.wikimedia.org/wiki/File:Researchers_review_cancer_data.jpg).
0 Comentarios
Deja una respuesta. |

Localiza aquí todo lo que te interese!
Quantum Showroom es ese lugar sin límites, pero donde ahora podrás encontrar, de una manera simple, todo lo que es nuestro mundo, en un solo lugar acceso a todos nuestros proyectos y contenidos! Bienvenidos a la sección donde con el impulso de todos nuestros proyectos y colaboradores, encontrarás una guía de todas las noticias, recursos, actividades, arte, videojuegos y muchas cosas más que impulsamos y nos interesan en este apasionante universo digital.
Este es un lugar compartido que te permite acceder a todo lo vinculado con nuestra gran familia. Podrás encontrar desde las actividades, recursos educativos o artículos en otros medios de comunicación donde colaboramos hasta nuestras alucinantes exposiciones virtuales o experiencias 3D. QB Inducido Podcast
Bienvenidos a nuestro Podcast!
Aquí podrás acceder o descargar nuestros podcast sobre cine, series y manga. Una experiencia diferente de las artes visuales, donde reflexionar y disfrutar con elegancia. Apto para cinéfilos/seriéfilos con poco tiempo libre! También puedes escucharlos y seguirnos desde iVoox, iTunes, Spotify y Amazon Music 


Recursos y noticias
|